【AI】Embedding 与混合检索:RAG 的语义检索链路
一、开篇:RAG 检索链路是什么
检索增强生成(RAG)要让大模型回答前,先从资料库中找到相关内容。这条链路的基石是 Embedding 向量与 向量检索,再配合关键词检索与融合排序,构成完整的召回链路。
二、Embedding(嵌入)
2.1 什么是 Embedding
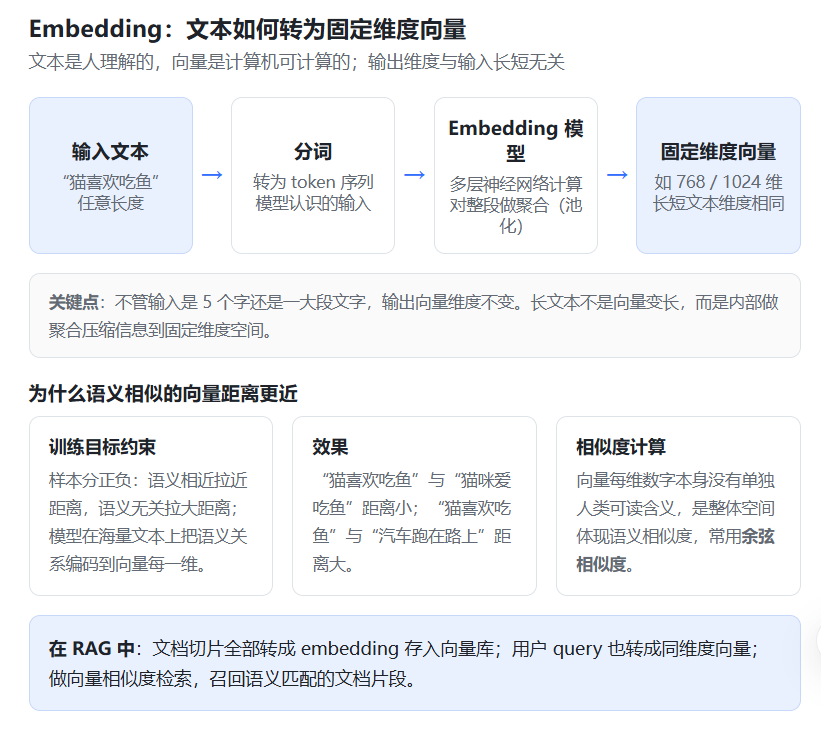
Embedding(嵌入)把人类可读的文本、词语,通过 Embedding 模型映射成一串固定维度的浮点数向量。文本是人理解的;向量是计算机可以做数学计算的表达。例如一句话输出 1024 维向量,就是 1024 个小数组成的数组。
2.2 文本怎么变成固定维度向量
流程为:输入文本经过分词,转为模型认识的 token 序列 → 送入预训练好的 Embedding 模型 → 模型经过多层神经网络计算,对整段文本做聚合(池化)→ 输出固定长度的浮点数向量。
关键点:不管输入是 5 个字还是一大段文字,输出向量维度不变(例如 768、1024 维)。长文本不是向量变长,而是内部做聚合压缩信息到固定维度空间。
2.3 为什么语义相似的文本,向量空间距离更近
根源来自 Embedding 模型的训练目标。训练时构造正样本(语义相近的句子)与负样本(语义无关的句子),损失函数约束语义相近→向量距离尽量小、语义差别大→向量距离尽量拉大。模型在海量文本上学习词语、句子之间的语义关联,把语义关系编码到向量每一维数值里面。
训练收敛后即形成该特性:“猫喜欢吃鱼” 与 “猫咪爱吃鱼” 语义接近,向量距离很小;“猫喜欢吃鱼” 与 “汽车跑在马路上” 语义无关,向量距离很大。向量每一维数字没有单独的人类可读含义,是整体空间体现语义相似度,常用余弦相似度衡量。
2.4 Embedding 在 RAG 中的作用
文档切片全部转为 embedding 向量存入向量库;用户 query 也转成同维度向量;做向量相似度检索,召回语义匹配的文档片段。
2.5 局限(面试加分)
- 语义相近不等于字面关键词相同:会出现语义相似但关键词完全不一样的召回,也会出现字面相近语义不一样的情况。
- 对歧义、多义词处理有限。
- embedding 质量高度依赖训练数据和模型本身。
三、向量检索、ANN、HNSW
3.1 向量检索是什么
RAG 中,文档切片和用户 Query 都被转为固定维度 Embedding 向量。向量检索:给定查询向量,在海量向量库中,找出和它相似度最高(距离最近)的 Top-N 向量,拿到对应的原始文本。相似度常用余弦相似度,距离常用欧式距离。
3.2 暴力检索(精确 KNN)的问题
遍历库里全部向量,逐个计算和查询向量的距离,排序取 TopN。结果 100% 准确,但数据量大时速度极慢,向量百万、千万级别完全不可用。所以生产环境不用 KNN,用 ANN 近似最近邻。
3.3 ANN 近似最近邻算法
ANN 全称 Approximate Nearest Neighbor,核心思想是牺牲一小部分召回准确率,换取巨大的检索速度提升。不遍历全部数据,只搜索一部分候选,返回近似最相似结果,不需要绝对全局最接近,业务上够用即可。
主流 ANN 实现包括 HNSW、IVF-FLAT、FAISS-IVF、PQ 乘积量化等,工业向量数据库最常用 HNSW。
3.4 HNSW 索引基本思想
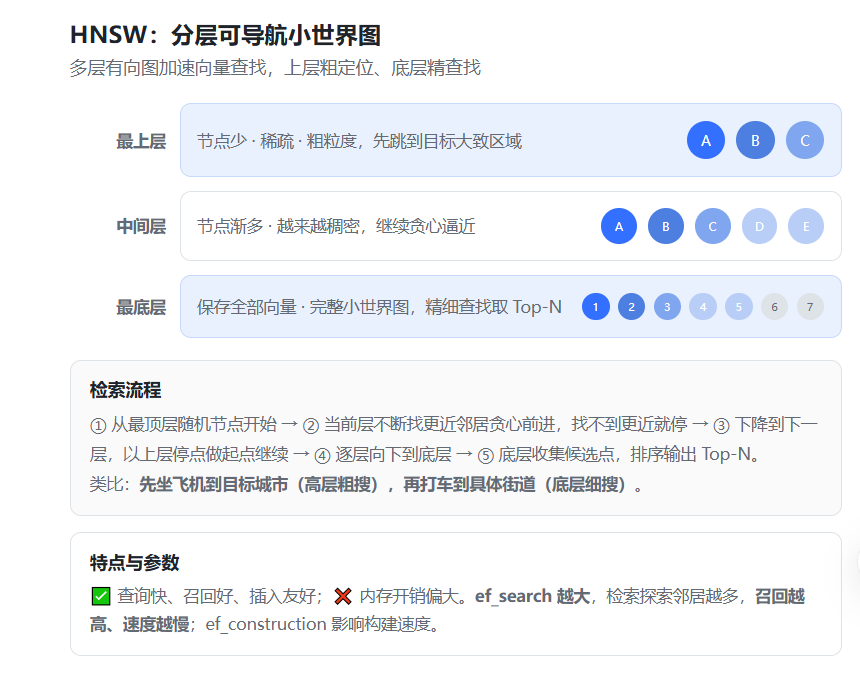
HNSW(Hierarchical Navigable Small-World,分层可导航小世界图)核心是分层图结构,用多层有向图加速向量查找。
- 多层图结构:最上层节点数量很少、稀疏、代表粗粒度;往下每一层节点越来越多、图越来越稠密;最底层存放全部向量,是完整的小世界图。
- 检索流程:从最顶层随机节点开始 → 当前层不断找比当前节点更近的邻居贪心前进,找不到更近就停止 → 下降到下一层,以上层停点做起点继续 → 逐层向下到底层 → 底层收集候选点,排序输出 Top-N。
- 上层作用:快速跳到目标向量大致所在区域(粗定位);底层再做精细查找,类似坐飞机先到目标城市,再打车到具体街道。
HNSW 特点:查询快、召回好、插入友好,但内存开销偏大。参数 ef_construction、ef_search 影响构建速度、检索速度和召回率——ef_search 越大,探索邻居越多,召回越高、速度越慢。
3.5 KNN / ANN / HNSW 三者关系
- KNN:暴力精确搜索,全量遍历,慢、准。
- ANN:一类算法总称,近似搜索,以精度换速度。
- HNSW:ANN 里的一种具体实现,分层图索引,向量数据库主流。
四、混合检索(向量检索 + BM25)
4.1 纯向量检索的问题
向量检索依靠语义相似度匹配,能找到语义相近但字面用词不同的内容,但存在明显短板。
- 关键词完全匹配也会漏召回:专有名词、编号、人名、设备型号、文档 ID 等要求字面严格命中。向量看整体语义,即便关键词完全一致,若上下文语义不强,向量相似度不一定高,会漏掉字面完全匹配的文档。示例:搜“订单号 A123456”,文档里正好有该订单号,但向量模型看整体上下文与 query 语义相似度不高,就召回不到。
- 容易出现“语义相似但事实无关”的结果:语义上接近,但不包含用户要的专有实体,产生噪声。
总结:向量检索擅长语义相似,不擅长精确实体、专有名词、关键词字面命中。
4.2 BM25 关键词检索是什么
BM25 是经典关键词检索算法,基于词频、逆文档频率打分,看重词是否出现、出现次数、重要程度,只做字面关键词匹配,不理解语义。优点:专有名词、编号、ID、关键词精准命中;缺点:不理解同义、转述,换个说法就搜不到。
4.3 为什么做混合检索(Hybrid Search)
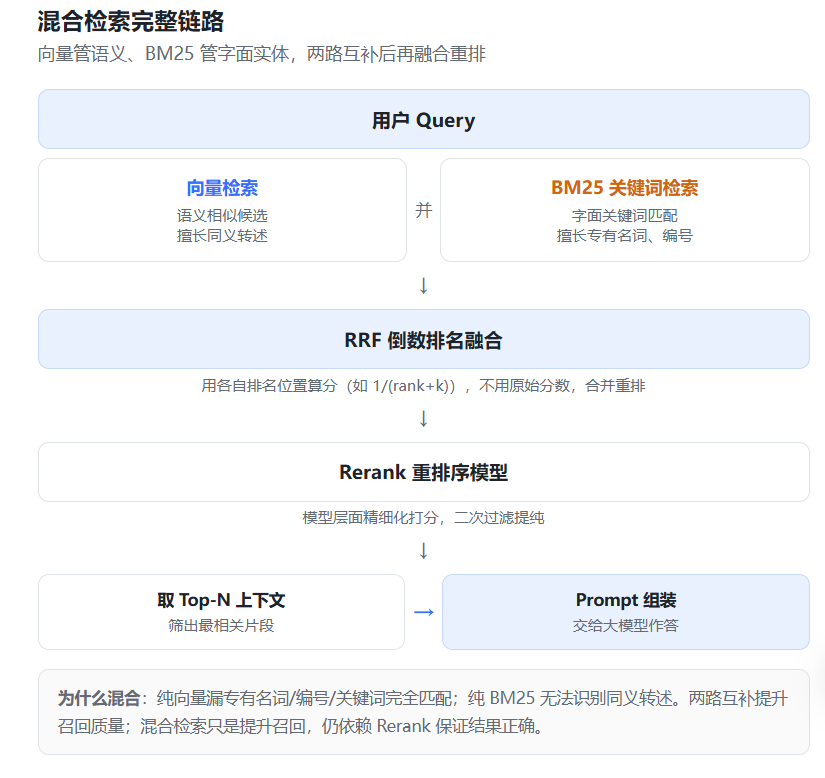
向量检索负责语义,BM25 关键词检索负责字面实体,两者互补。流程:用户 query 同时走两路检索 → 向量检索召回语义相似候选、BM25 召回关键词字面匹配候选 → 将两路结果融合(加权打分、RRF 倒数排名融合是常用方式),合并重排得到候选集合 → 再送入 Rerank 重排序模型做二次过滤提纯。
这解决两类问题:弥补纯向量检索漏掉专有名词、编号、关键词完全匹配的文档;弥补纯关键词检索无法识别同义转述的缺陷。
4.4 局限
混合检索只是提升召回质量,不能保证结果一定正确,依然依赖后续 Rerank 做筛选。
五、RRF 倒数排名融合
5.1 为什么不能直接把两路分数相加
向量检索返回余弦相似度/距离,值域与分布由 Embedding 模型决定;BM25 返回打分,值域与分布由词频统计决定。两者分数不在同一个量纲,含义完全不一样,不能直接相加排序,直接相加会导致某一路结果权重被不合理放大。于是用到 RRF 倒数排名融合。
5.2 RRF 核心思想
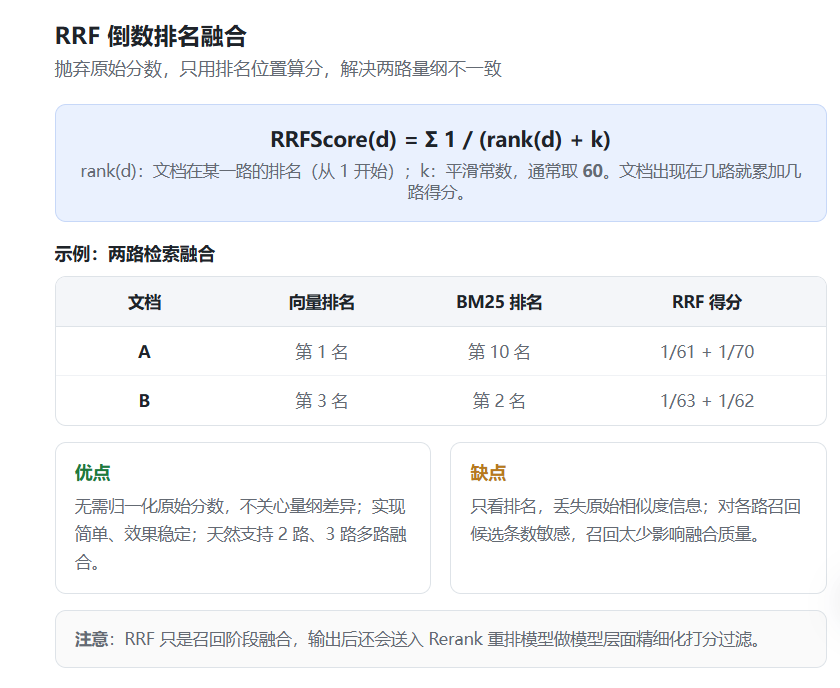
抛弃原始分数,只使用每条文档在各路返回结果里的排名位置来计算融合分数。公式:
RRFScore(d) = Σ 1 / (rank(d) + k)
- rank(d):文档 d 在某一路检索结果中的排名,从 1 开始;没有出现在该路结果里则不计入。
- k:平滑常数,通常取 60(工业常用默认值),降低排名靠前和靠后的差距,避免第一名权重过大。
- 文档出现在几路,就累加几路的得分,最后按 RRFScore 从高到低重新排序。
示例:文档 A 向量第 1、BM25 第 10(得分 1/61 + 1/70);文档 B 向量第 3、BM25 第 2(得分 1/63 + 1/62)。两路都靠前的文档累加得分更高。
5.3 RRF 的优点与缺点
- 优点:不需要归一化各路原始分数,不关心量纲差异;实现简单、效果稳定,RAG 混合检索工业最常用;天然支持 2 路、3 路多路融合。
- 缺点:只看排名,丢失原始相似度信息;对各路召回候选条数敏感,各路召回太少会影响融合质量。
5.4 完整链路位置
query → 向量检索 + BM25 检索 → 两路候选 → RRF 融合得到统一排序列表 → Rerank 重排序 → 取 top-N 上下文 → Prompt 组装。RRF 只是召回阶段的融合,输出后还会送入 Rerank 模型做精细打分过滤。