【AI】RAG 全解析:从概念到完整 Pipeline
一、开篇:RAG 是什么
RAG 全称 Retrieval-Augmented Generation,检索增强生成。简单说,就是检索 + 大模型生成的一套架构。
二、RAG 的工作流程
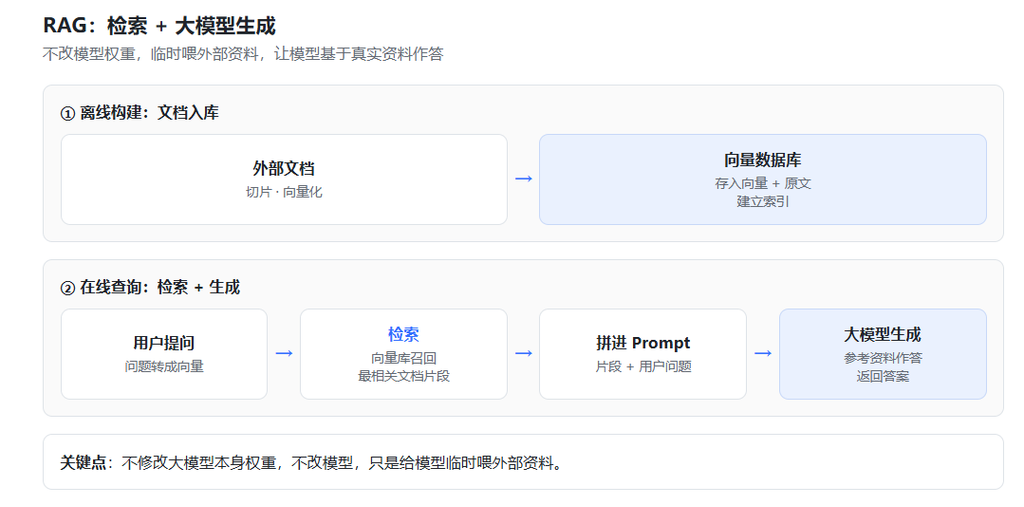
RAG 的完整流程可以拆成四步:
- 提前把外部文档做切片、向量化,存入向量数据库。
- 用户提问时,把问题也转为向量,去向量库检索出和问题最相关的文档片段。
- 把检索出来的片段,连同用户问题一起拼进 Prompt 喂给大模型。
- 大模型参考给到的参考资料,基于资料生成答案。
关键点:不修改大模型本身权重,不改模型,只是给模型临时喂外部资料。
三、RAG 主要解决大模型的几个痛点
- ① 知识截止问题:大模型知识库是训练时固定的,不知道最新数据、新业务资料。RAG 可以接入实时/新增文档。
- ② 幻觉问题:让模型基于检索到的真实文档作答,减少一本正经编造内容,答案可以溯源到原文。
- ③ 私有知识库使用:企业内部文档、业务手册,不需要重新训练模型,直接拿来用。
- ④ 绕开上下文窗口限制:不需要把全部文档塞进去,只检索相关片段送入模型,避免超长文本超限。
四、RAG 的局限
RAG 不会提升模型本身能力,不会改变模型输出风格。如果检索召回的内容不对,模型就会基于错误资料给出错误答案;效果依赖文档质量、切片质量、检索效果。
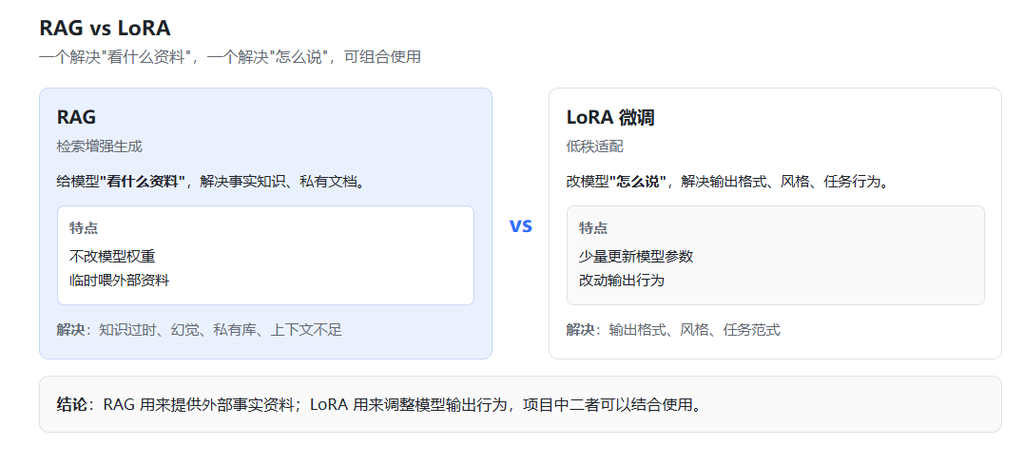
五、RAG vs LoRA
- RAG:给模型”看什么资料”,解决事实知识、私有文档;不改模型权重。
- LoRA 微调:改模型”怎么说”,解决输出格式、风格、任务行为;少量更新模型参数。
- 两者可以组合使用。
六、RAG 完整 Pipeline
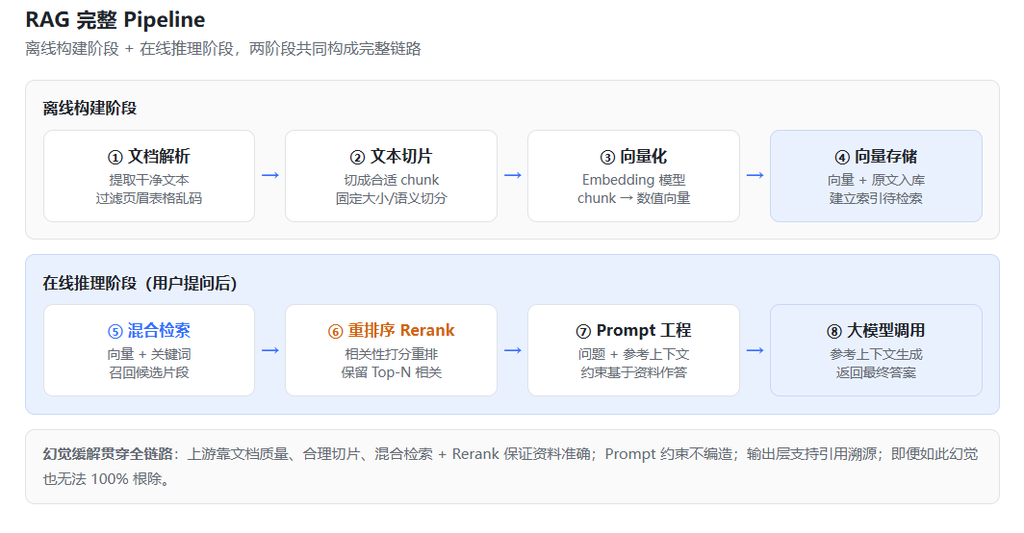
完整工作链路分为离线构建与在线推理两个阶段。
6.1 文档解析
拿到原始文件(PDF、Word、网页等),做解析,提取出里面的文本内容,过滤页眉页脚、表格乱码、无效格式,输出干净文本。目标:把各类格式文档转为可用纯文本。
6.2 文本切片(Chunk 切分)
把长文本切为多个 chunk 片段。不能切太碎丢失上下文,也不能太大(否则噪声多、token 消耗高)。常用固定大小切分、语义切分。目标:产出适合检索的文本片段。
6.3 向量化(Embedding)
调用 Embedding 嵌入模型,把每一个文本 chunk 转换成高密度数值向量。语义相近的文本,向量在空间上距离更近。目标:文字变成向量,用来做相似度匹配。
6.4 向量存储
把生成好的向量连同原始文本 chunk 一起存入向量数据库,建立索引,为后续快速检索做准备。
6.5 混合检索
用户提问,问题同样做 Embedding。混合检索一般是向量检索 + 关键词检索:向量检索靠语义相似度召回;关键词检索靠关键词字面匹配(如 BM25)。两者结果合并,拿到一批候选文档片段。
只靠向量检索容易出现语义相似但字面不匹配,混合检索提升召回全面性。
6.6 重排序(Rerank)
混合检索返回一批候选,数量偏多,部分相关性不高。Rerank 重排模型对候选片段和用户问题做相关性打分,重新排序,过滤掉低分无关片段,只保留 Top-N 最相关的内容。Rerank 是 RAG 效果提升非常关键的一步,提纯检索结果。
6.7 Prompt 工程
把用户原始问题 + Rerank 筛选后的参考上下文,组装成 Prompt 提示词。提示词约束模型:严格基于给出的参考资料回答,资料没有就如实说不知道,不要编造。
6.8 大模型调用
将组装好的 Prompt 送入大模型,大模型参考上下文生成最终答案返回给用户。
七、幻觉缓解(贯穿全链路)
幻觉不是单一环节解决,整套链路共同缓解:
- 上游:文档质量、合理切片、混合检索 + Rerank,保证给到模型的资料准确相关。
- Prompt 约束:要求不编造,不知道就说明。
- 输出层:支持引用原文片段溯源。
- 即便如此,幻觉也无法 100% 根除。
八、总结
- 离线构建阶段:检索阶段(解析-切片-向量化-入库)。
- 在线推理阶段:用户来了之后(混合检索-Rerank-Prompt-LLM 调用)。