
【AI】从 Token 到上下文窗口:大模型如何“读”懂文字
一、开篇:为什么关心 Token
无论是写提示词、选模型,还是评估成本,Token 都是绕不开的基础概念。它决定了文本占用多少上下文、消耗多少算力。理解 Token 与分词器,是正确使用大模型的第一步。
二、两个基础概念
什么是 Token
Token 是模型处理的最小单位,不等于汉字或单词。它不是按空格切、也不是按汉字切,而是模型训练时学习出来的子词切分规则。
- 英文示例:
apple可能就是 1 个 token;unhappiness可能拆成un+happiness两个 token。 - 因此 token 与“字数”没有固定对应关系,不同模型、不同分词器切分结果也可能不同。
什么是 Tokenizer
Tokenizer 叫分词器,负责把人类文本转成模型能看懂的数字。它的核心职责就是切词,是文本进入模型前的第一道工序。
三、文字是怎么变成模型输入数字的
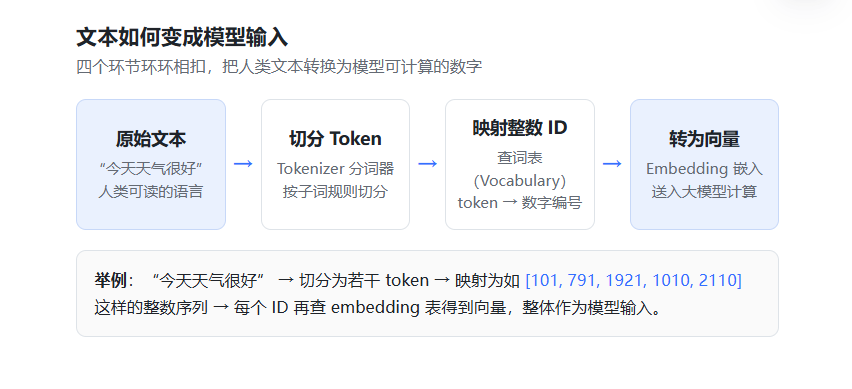
整个过程是一条清晰的流水线:原始文本 → Tokenizer 切分成一个个 token 片段 → 查表转换成对应的整数 ID → 再转为向量,送入大模型。
四、为什么中文一个汉字可能对应多个 token
原因在于词表容量有限,且训练数据中英文占比较大。
- 常用汉字一般占 1 个 token。
- 生僻字在词表中没有,就会被拆成多个子单元,因此出现“一个汉字对应多个 token”的情况。
也正因如此,中文在相同字数下往往消耗更多 token,占用更多上下文长度——同样的预算,中文能装进的内容比英文更少。
五、什么是上下文窗口
上下文窗口就是大模型一次最多能同时处理的 token 总数,包含输入提示词,加上模型自己生成的输出 token。超过这个数量,模型就无法正常工作。
它既是一个能力上限,也是一个成本与效果的天花板:窗口越大,能一次性喂入的信息越多,但算力和显存代价也越高。
六、为什么会存在长度限制
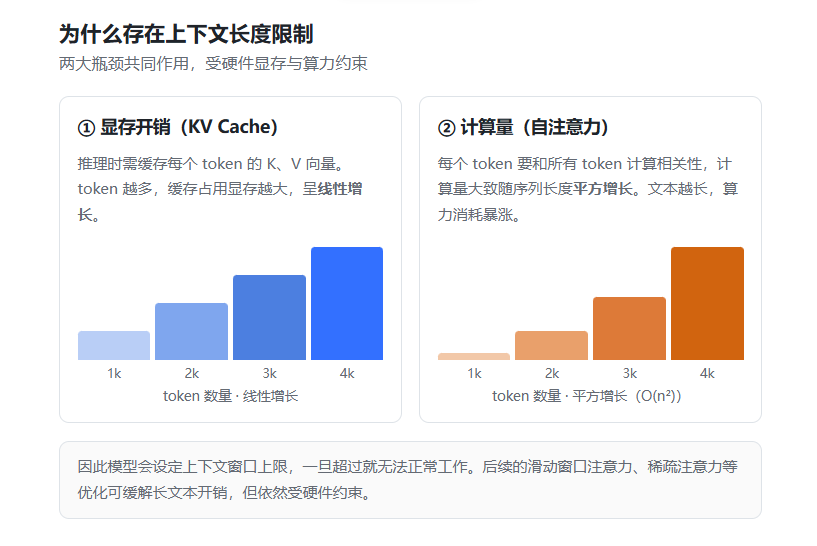
长度限制来自两个硬约束:显存开销与计算量。
- 显存开销(KV Cache):推理时 KV Cache 要保存所有 token 的 K、V 向量,token 越多,缓存占用显存就越大。
- 计算量(自注意力):自注意力机制中,每一个 token 要和所有 token 算相关性,计算量大致随序列长度平方增长。文本越长,算力消耗暴涨。
硬件显存、算力是有限的,所以模型会设置上下文窗口上限。
七、上下文超限之后的常用处理方案
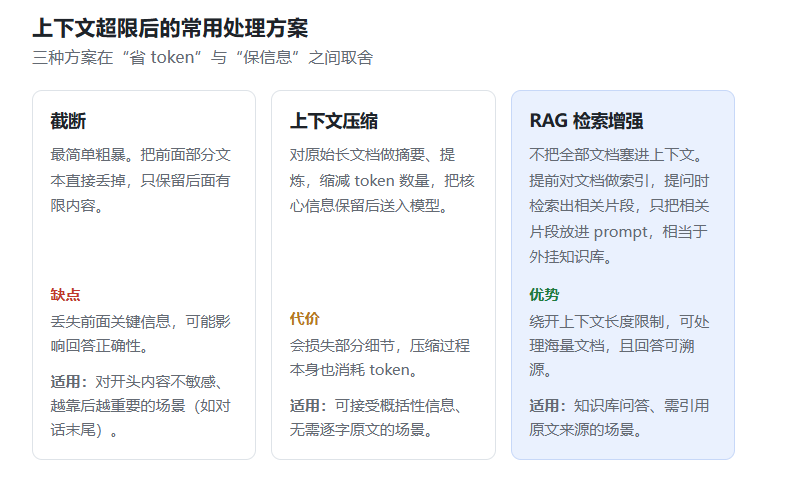
当内容超出上下文窗口,常见做法有三类,核心是在“省 token”与“保信息”之间做取舍。
截断
最简单粗暴,把前面部分文本直接丢掉,只保留后面有限内容。缺点:丢失前面关键信息。
上下文压缩
对原始长文档做摘要、提炼,缩减 token 数量,把核心信息保留后送入模型。代价:损失部分细节。
RAG检索增强生成
不把全部文档塞进上下文窗口。提前把文档做索引,用户提问时检索出与问题相关的片段,只把相关片段放进 prompt。相当于外挂知识库,绕开上下文长度限制。
八、结语:技术的优化方向
现在也有一些技术优化,比如滑动窗口注意力、稀疏注意力,用来缓解长文本开销,但依然受硬件约束。
理解了 Token、分词器与上下文窗口,你就能更好地规划提示词、评估模型选择,并在长文本场景下做出合理的处理策略。