【AI】自注意力机制与 KV Cache:大模型如何逐 token 生成
二、自注意力机制
2.1 一句话原理
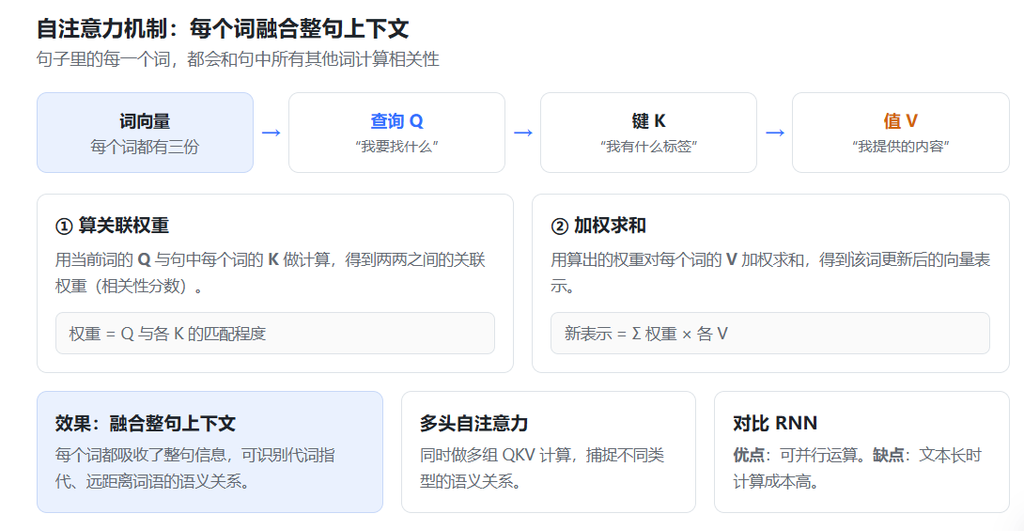
自注意力,就是句子里的每一个词,都会和句子当中所有其他词计算相关性。首先通过查询和键算出两两之间的关联权重,再拿这个权重对值向量加权求和,更新每个词的向量表示。
2.2 它带来了什么
经过自注意力,每个词就融合了整句上下文的信息,例如识别代词指代、远距离词语的语义关系。
2.3 多头自注意力
多头自注意力就是同时做多组这样的计算,捕捉不同类型的语义关系。不同”头”关注不同维度,合起来覆盖更丰富的上下文模式。
2.4 与 RNN 的对比
和 RNN 相比,自注意力可以并行运算;缺点是文本长的时候计算成本会很高——这也是后文 KV Cache 与长度限制问题的根源。
三、KV Cache:为什么第一个 token 慢,后面快
3.1 背景:逐 token 生成
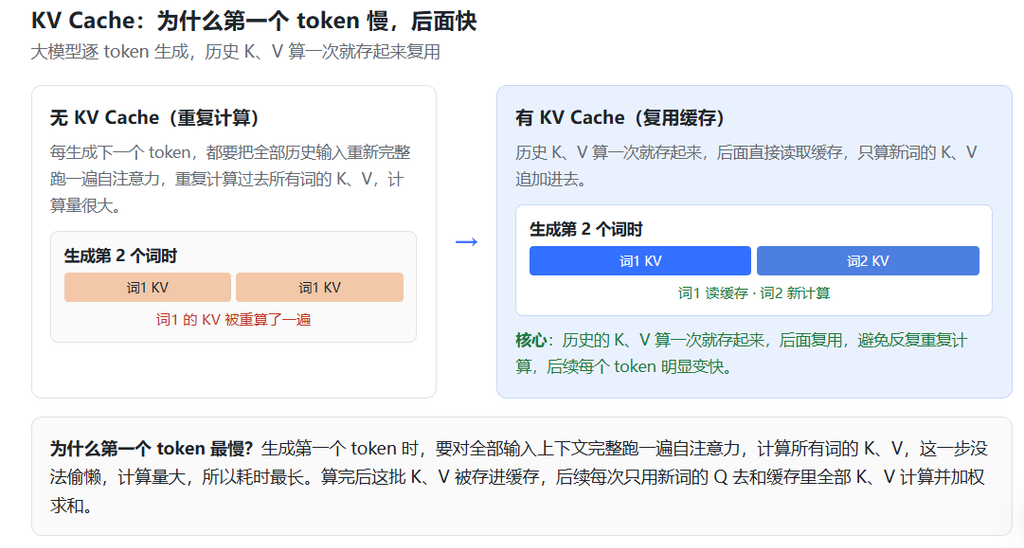
大模型生成文本是逐 token 输出的:出完一个词,再把这个词塞回输入,再算下一个词。如果没有 KV Cache,每生成下一个 token,就要把全部历史输入重新完整跑一遍自注意力,每一步都重复计算过去所有词的 K、V 向量,计算量很大。
3.2 KV Cache 到底在做什么
KV Cache 就是缓存已经算好的 Key 和 Value 向量。
- 生成第一个 token:要对全部输入上下文完整跑一遍自注意力,计算所有词的 K、V,这一步没法偷懒,计算量大,所以第一个 token 耗时最长。算完之后,把这批 K、V 存下来,这就是 KV Cache。
- 后续每生成一个新 token:只需要计算这个新词对应的 K、V,追加到缓存里;历史所有词的 K、V 不再重复计算,直接读取缓存。
- 计算输出:自注意力计算时,用当前新 token 的 Q,去和缓存里全部 K、V 做计算,加权求和得到输出。
3.3 核心一句话
历史的 K、V 算一次就存起来,后面复用,避免反复重复计算,所以后面每个 token 速度明显变快。
四、KV Cache 存在的问题
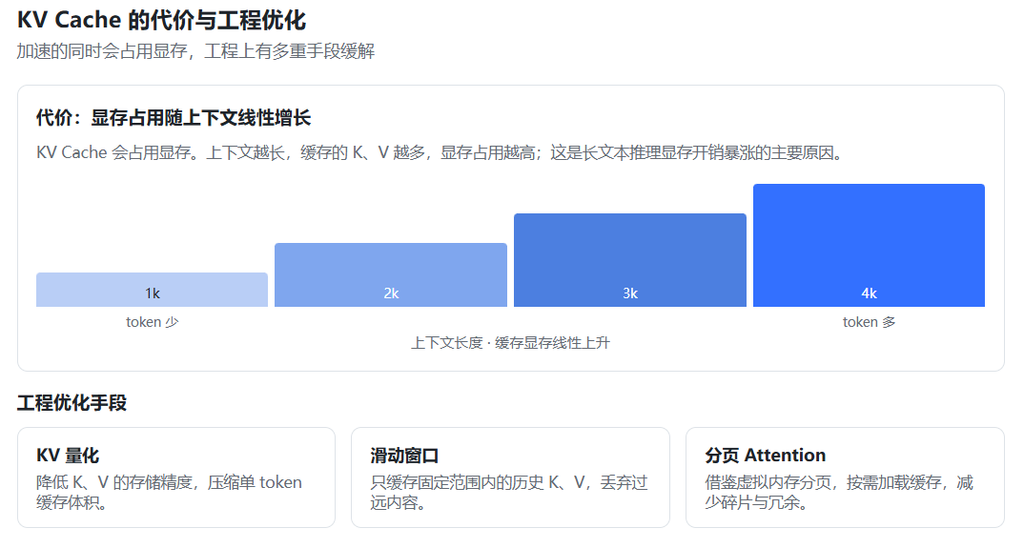
KV Cache 会占用显存。上下文越长,缓存的 K、V 越多,显存占用就越高;这也是长文本推理显存开销暴涨的主要原因。
工程上会做优化,比如 KV 量化、滑动窗口、分页 Attention 等,用来降低显存压力。
五、总结
KV Cache 主要用于大模型推理加速。大模型是逐个 token 生成的,如果不做缓存,每生成下一个词,都要重新计算全部历史 token 的 K、V 向量,大量计算被重复执行。KV Cache 把已经计算完成的 Key、Value 向量保存在显存中。第一个 token 需要处理全部上下文,完整计算一遍 K、V,所以速度慢;之后每来一个新 token,只计算新词的 K、V 并追加进缓存,历史部分直接读取缓存结果,不再重复运算,因此后续 token 生成速度快。代价就是会占用显存,文本越长,显存消耗越大。